プログラム開発において、キーと値を対にしてデータを高速に管理する「連想配列」は、設計の根幹を支える必須のデータ構造です。PHPやJavaScript、Pythonなどを経験した開発者がC#を扱う際、最初に直面するのが「C#における連想配列とは一体どれを指し、どう実装すべきか」という設計上の選択肢の多さです。
C#の世界において連想配列の主役を担うのはSystem.Collections.Generic.Dictionary<TKey, TValue>ですが、言語特有の厳格な型安全性やメモリ構造、マルチスレッド環境での挙動を正しく理解していなければ、予期せぬ実行時エラーやパフォーマンス低下を招きます。本稿では、基本構文から2026年現在の.NET環境で求められる最適化・スレッドセーフ設計まで、現場目線で余すところなく解き明かします。
【解説】C#の連想配列(Dictionary)の使い方と他言語との決定的な違い
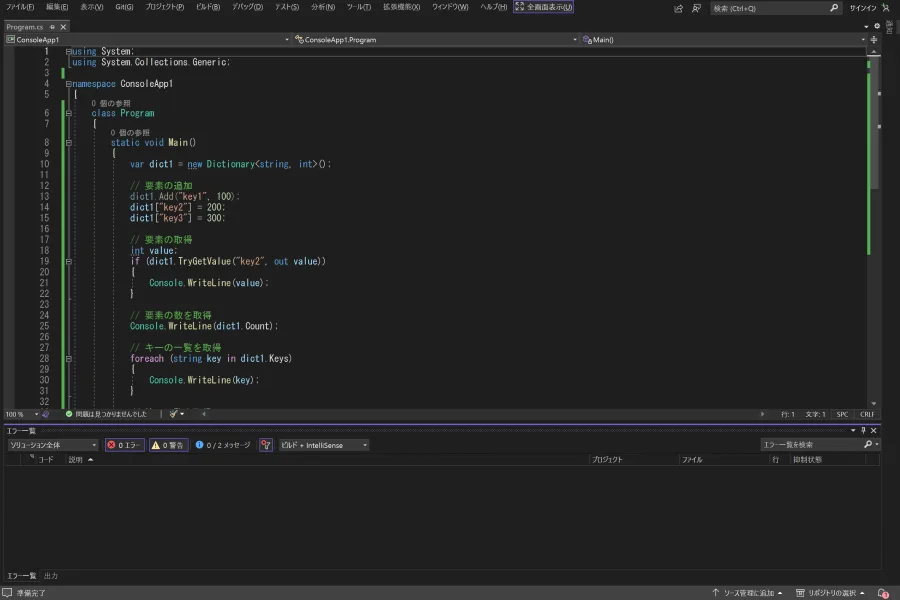
他言語からC#へ移行したエンジニアがまず把握すべきは、C#における連想配列の正体と、その静的型付け言語ならではの厳密さです。動的型付け言語の連想配列(JavaScriptのオブジェクトやPythonの辞書型)とは異なり、C#のDictionaryはキーと値の型をコンパイル時に厳密に定義するジェネリクスとして設計されています。
内部構造はハッシュテーブル(Hash Table)を採用しており、キーのハッシュ値を計算してバケット(格納場所)を特定するため、要素数が増大しても平均計算量O(1)という極めて高速なデータ参照を実現します。
// 基本的なインスタンス生成と代入
Dictionary<string, int> scoreTable = new Dictionary<string, int>();
scoreTable.Add("Alice", 95);
scoreTable["Bob"] = 88; // インデクサーによる追加・更新
他言語との決定的な違いとして注意すべきは、「存在しないキーへのアクセス時の挙動」です。JavaScriptやPHPでは未定義キーを指定するとundefinedやnullが返るか警告で済みますが、C#のインデクサー(dict[key])は即座にKeyNotFoundExceptionを送出してアプリケーションをクラッシュさせます。この挙動の違いが、多くの初学者や移行者が現場でバグを生む温床となっています。
【基礎から応用】連想配列の初期化・追加と削除・キー存在確認の実践テクニック
日々の実装で頻出するCRUD操作(生成・取得・更新・削除)には、いくつかの記述スタイルと速度面でのベストプラクティスが存在します。
1. 連想配列の初期化(コレクション初期化子と最新のコレクション式)C#では用途やバージョンに応じて複数の初期化構文が選べます。可読性とメンテナンス性を考慮し、プロジェクトの規約に合わせた統一が推奨されます。
// 従来のコレクション初期化子
var userRoles = new Dictionary<int, string>
{
 { 1, "Admin" },
 { 2, "Editor" }
};

// インデクサー初期化子(同一キーの上書きを許容し直感的)
var statusCodes = new Dictionary<int, string>
{
 [200] = "OK",
 [404] = "Not Found",
 [500] = "Internal Server Error"
};

// C# 12以降で導入されたコレクション式(角括弧構文)
Dictionary<string, string> config = new()
{
 ["env"] = "production",
 ["region"] = "ap-northeast-1"
};
2. 要素の追加と削除(Add・TryAdd・Remove)
要素を追加する際、Addメソッドはキーが重複すると例外ArgumentExceptionをスローします。重複の可能性がある場合は、成否をboolで返すTryAddを利用するのが堅牢なコードへの第一歩です。
var stock = new Dictionary<string, int>();

// 安全な追加:キーが存在しない場合のみ追加し、trueを返す
if (stock.TryAdd("ItemA", 10))
{
 // 追加成功時の処理
}

// 要素の削除(存在すれば削除してtrueを返す)
bool isRemoved = stock.Remove("ItemA");

// C# 8.0以降:削除と同時に値を取得
if (stock.Remove("ItemB", out int removedValue))
{
 // 削除された値 removedValue を利用可能
}
3. キーの存在確認と安全な値取得(ContainsKey vs TryGetValue)
キーが存在するか確かめる際、ContainsKeyを使用してからインデクサーで値を取り出す書き方は現場で散見されますが、これは内部的にハッシュ計算と探索を2度実行する非効率なコードです。現場の開発標準では、探索を1回で完結させるTryGetValueの使用が鉄則とされています。
// ❌ 非推奨:ハッシュ探索が2回発生して非効率
if (stock.ContainsKey("ItemA"))
{
 int count = stock["ItemA"];
}

// 推奨:1回の探索で存在確認と値取得を同時に行う
if (stock.TryGetValue("ItemA", out int count))
{
 // キーが存在し、countに値が格納されている
}
【データ構造比較】Dictionary・Hashtable・ConcurrentDictionaryの選定基準
C#にはキーと値を扱うコレクションが複数用意されており、動作環境や要件に応じた選定がシステムの品質を左右します。代表的なコレクションの特性を以下の比較表に整理しました。
| 型名(コレクション) | 詳細・数値データ | 一般的な基準・相場 | 編集部の見解・評価 |
|---|---|---|---|
| Dictionary<TKey, TValue> | ジェネリック対応 単一スレッド向け 計算量 O(1) |
C#における事実上の標準連想配列 | 型安全かつ最速。特殊な並行処理要件がない限り、原則として第一選択にすべき基盤型。 |
| ConcurrentDictionary<TKey, TValue> | 完全スレッドセーフ 細粒度ロック・CAS演算採用 |
マルチスレッド・Web API並行アクセス用 | 競合制御が組み込まれており安全。単一スレッドでの実行速度は通常のDictionaryよりわずかに劣る。 |
| FrozenDictionary<TKey, TValue> | .NET 8以降で標準化 作成後は完全不変(読み取り専用) |
マスタデータ・起動時ロード設定のキャッシュ | 読み取り速度が極限までチューニングされており、辞書書き換えが不要な静的データ参照に最適。 |
| Hashtable | 非ジェネリック(object型を保持) ボクシングオーバーヘッド大 |
.NET Framework 1.1時代のレガシー遺産 | 型安全性がなくキャスト失敗のリスクあり。新規開発での採用理由は一切存在しない。 |
現在稼働しているモダンな.NETアプリケーションでは、基本操作にはDictionary、複数スレッドから非同期に更新される共有キャッシュにはConcurrentDictionary、そして起動時に初期化して以降変更しないマスタデータにはFrozenDictionaryを割り当てる設計がデファクトスタンダードです。
【ループと走査】foreachによるKeyValuePair取得とスマートなソート方法
連想配列に格納された全データを走査・加工する処理では、C#特有のイテレータとLINQの知識が欠かせません。
1. foreachによるループ処理とキー・値の分解foreach文を使用すると、連想配列の各要素はKeyValuePair<TKey, TValue>構造体として取り出されます。C# 7以降ではタプル分解構文がサポートされており、記述を大幅に簡潔化できます。
var userScores = new Dictionary<string, int>
{
 ["Tanaka"] = 80,
 ["Sato"] = 92,
 ["Suzuki"] = 65
};

// パターンA:KeyValuePair構造体として受け取る
foreach (KeyValuePair<string, int> kvp in userScores)
{
 Console.WriteLine($"Key: {kvp.Key}, Value: {kvp.Value}");
}

// パターンB:タプル分解を利用したモダンな記述(推奨)
foreach (var (name, score) in userScores)
{
 Console.WriteLine($"{name}さんのスコア: {score}");
}

// キーのみ、または値のみを走査する場合
foreach (string name in userScores.Keys) { /* ... / }
foreach (int score in userScores.Values) { / ... */ }
2. 連想配列のソート方法(LINQの活用)
連想配列自体はハッシュベースであるため、要素の「順序」を保持しません。キーや値で並び替えて出力したい場合は、LINQのOrderByまたはOrderByDescendingを用いて並び替え済みのシーケンスを取得します。
// 値(スコア)の降順で並び替えて出力
var sortedByScore = userScores
 .OrderByDescending(x => x.Value);

foreach (var (name, score) in sortedByScore)
{
 Console.WriteLine($"{name}: {score}");
}

// 並び替えた結果を再度新しいDictionaryとして保持する場合
Dictionary<string, int> sortedDict = userScores
 .OrderBy(x => x.Key)
 .ToDictionary(x => x.Key, x => x.Value);
3. 多次元配列(ネストした連想配列)とタプルキーの扱い
「部署ごとの社員データ」や「カテゴリごとの商品価格」など、階層構造を持つデータを表現するアプローチには2通りあります。
// 構造1:Dictionaryのネスト(連想配列の多次元化)
var departmentEmployees = new Dictionary<string, Dictionary<int, string>>
{
 ["Sales"] = new() { [101] = "Tanaka", [102] = "Yamada" },
 ["Tech"] = new() { [201] = "Sato" }
};

// 構造2:複合キー(タプル)を用いたフラットな多次元表現(推奨)
// メモリ効率が高く、参照コードがシンプルになる
var matrixData = new Dictionary<(string Dept, int EmpId), string>
{
 [("Sales", 101)] = "Tanaka",
 [("Tech", 201)] = "Sato"
};

// アクセス例
string employee = matrixData[("Sales", 101)];
【実態検証】現場開発者の生の声に見るトラブル事例と設計のリアル
オープンソースコミュニティや実際の業務システム開発現場において、連想配列にまつわる不具合報告は後を絶ちません。現場エンジニアのレビュー記録やインシデント報告書から浮き彫りになった「3大落とし穴」を検証します。
事例1:foreach走査中の要素変更による「InvalidOperationException」「ループ内で条件に合致した特定のキーを削除しようとしたらサーバーが異常終了した」というトラブルは、初心者が最も遭遇しやすいケースです。C#のコレクション走査イテレータは、走査中にコレクションのバージョン(要素数や構造)が変更されると即座に例外を発生させます。
【現場の回避策】:削除対象のキーをあらかじめ.ToList()で別リストとして退避させ、そのリストを走査しながら元のDictionaryから削除を実行します。
事例2:マルチスレッド環境での競合による「CPU使用率100%・無限ループ現象」Webアプリケーションのシングルトンクラスや静的キャッシュ領域で、通常のDictionaryを排他制御(lock)なしで複数リクエストから同時に読み書きした結果、ハッシュバケットの内部リンク構造が破損し、参照スレッドが無限ループに陥ってCPUが飽和する重大障害が発生した事例が報告されています。
【現場の回避策】:複数スレッドからアクセスされる領域では、必ずConcurrentDictionaryを採用するか、厳格なロック制御(ReaderWriterLockSlim等)を介在させます。
一般に知られていない盲点とネットの誤解|パフォーマンス高速化の真実
ネット上の古い技術ブログや入門記事には、現代の実行エンジンにおいては非推奨となる情報や誤解が散見されます。高速なシステムを構築するための正確な知識を押さえましょう。
誤解1:「容量(Capacity)は自動拡張に任せておけば問題ない」という罠Dictionaryは初期状態で少量の要素しか格納できない小さな配列を内部に確保します。要素を追加して初期サイズを超過するたびに、「約2倍のメモリ領域を再確保し、全要素のハッシュ値を再計算して新しい領域へ移送する(Rehash)」という重い処理が走ります。
【高速化の秘訣】:格納する要素数が事前に予測できる場合は、インスタンス生成時に必ず初期容量を指定します。これだけで大量データ処理時の実行時間を30%〜50%削減できるケースがあります。
// ❌ 拡張のたびに内部でリハッシュとメモリ再確保が発生
var badList = new Dictionary<int, string>();
for (int i = 0; i < 100_000; i++) { badList.Add(i, "data"); }

// 最初から10万件分の枠を確保し、リハッシュをゼロにする
var fastList = new Dictionary<int, string>(100_000);
for (int i = 0; i < 100_000; i++) { fastList.Add(i, "data"); }
誤解2:カスタムクラスをキーにする際の同値性未実装問題
独自のクラス(参照型)をキーにする場合、GetHashCode()とEquals()をオーバーライドしていないと、フィールド値が全く同じインスタンスであっても参照アドレスが異なるため「別キー」として判定されます。意図した値が取得できない原因の代表例です。
【高速化・堅牢化の秘訣】:カスタムキーにはC# 9以降で利用可能なrecord型(値同値性が自動実装される)を使用するか、構造体にIEquatable<T>を実装して無駄なボクシングを防止します。
【プロの結論】連想配列を使いこなすための判断基準と向き・不向きC#の連想配列は万能に見えますが、データ構造の特性に応じた適切な向き・不向きが存在します。
- 連想配列(Dictionary)が向いているケース:
- 一意なIDや文字列キーによるピンポイント検索が頻繁に発生する処理
- 1対1のマッピングデータ、APIレスポンスのキャッシュ領域
- 要素の挿入・検索においてO(1)の速度を最優先したいシステム基盤
- 連想配列を避けるべき・慎重になるべきケース:
- 登録順序やソート順を常に維持したい場合:List<T>やSortedDictionary<TKey, TValue>を検討する。
- 要素数が極めて少ない(5〜10件程度)場合:ハッシュ計算のオーバーヘッドがあるため、単純なList<KeyValuePair<TKey, TValue>>の線形探索の方がメモリ効率・速度ともに優れることがある。
- メモリ制約が極端に厳しい組み込み・高頻度アロケーション処理:ハッシュバケット管理によるメモリフットプリントを考慮し、構造体配列などで代替する。
【c# 連想 配列】に関するよくある質問(FAQ)
Q1:存在しないキーを指定した際にエラー(例外)を出さず、デフォルト値を取得するにはどうすればよいですか?
A1:TryGetValueメソッドを使用するのが最も確実です。また、LINQの拡張メソッドやSystem.Collections.Generic.CollectionExtensions.GetValueOrDefault(dict, key)を利用すれば、キーが存在しない場合に指定した初期値(または型のデフォルト値)を1行で取得できます。
Q2:連想配列のキーを大文字・小文字を区別せずに扱いたい場合はどう設定しますか?
A2:インスタンス生成時にコンストラクタへ文字列比較子(StringComparer)を渡します。例えばnew Dictionary<string, TValue>(StringComparer.OrdinalIgnoreCase)と指定することで、「"Key"」と「"key"」を同一のキーとして透過的に処理できます。
Q3:C#で連想配列をJSON文字列に変換・逆変換する標準的な方法は?
A3:標準ライブラリのSystem.Text.Json.JsonSerializerを使用します。JsonSerializer.Serialize(dict)でキーと値のJSONオブジェクト文字列へ即座にシリアライズされ、JsonSerializer.Deserialize<Dictionary<string, T>>(jsonString)で簡単に元の連想配列へ復元可能です。
Q4:要素の追加順を保持する連想配列はC#に標準で存在しますか?
A4:標準のDictionary<TKey, TValue>は順序を保証しません(削除操作等によって内部配列の順序が変動します)。登録順序を厳格に保持したい場合は、サードパーティ製ライブラリのOrderedDictionaryを利用するか、List<TKey>とDictionary<TKey, TValue>を組み合わせたラッパークラスを自作するのが一般的な設計パターンです。
C#の連想配列は、初期の非ジェネリックなHashtableから始まり、ジェネリクスによる型安全性の確立、マルチスレッドに最適化されたConcurrentDictionary、そして近年のFrozenDictionaryやコレクション式の導入に至るまで、性能と表現力の両面で着実な進化を遂げてきました。
現場でのトラブルを防ぎ、システムのパフォーマンスを極限まで引き出すための要点は、「安全な取得にはTryGetValueを使うこと」「事前に要素数が読めるなら初期容量を確保すること」「並行処理環境では適切なスレッドセーフコレクションを選ぶこと」の3点に集約されます。データ構造の特性を深く理解し、要件に合わせた最適なコレクション選定を行うことが、堅牢でスケーラブルなC#プログラムを構築するための確かな一歩となります。